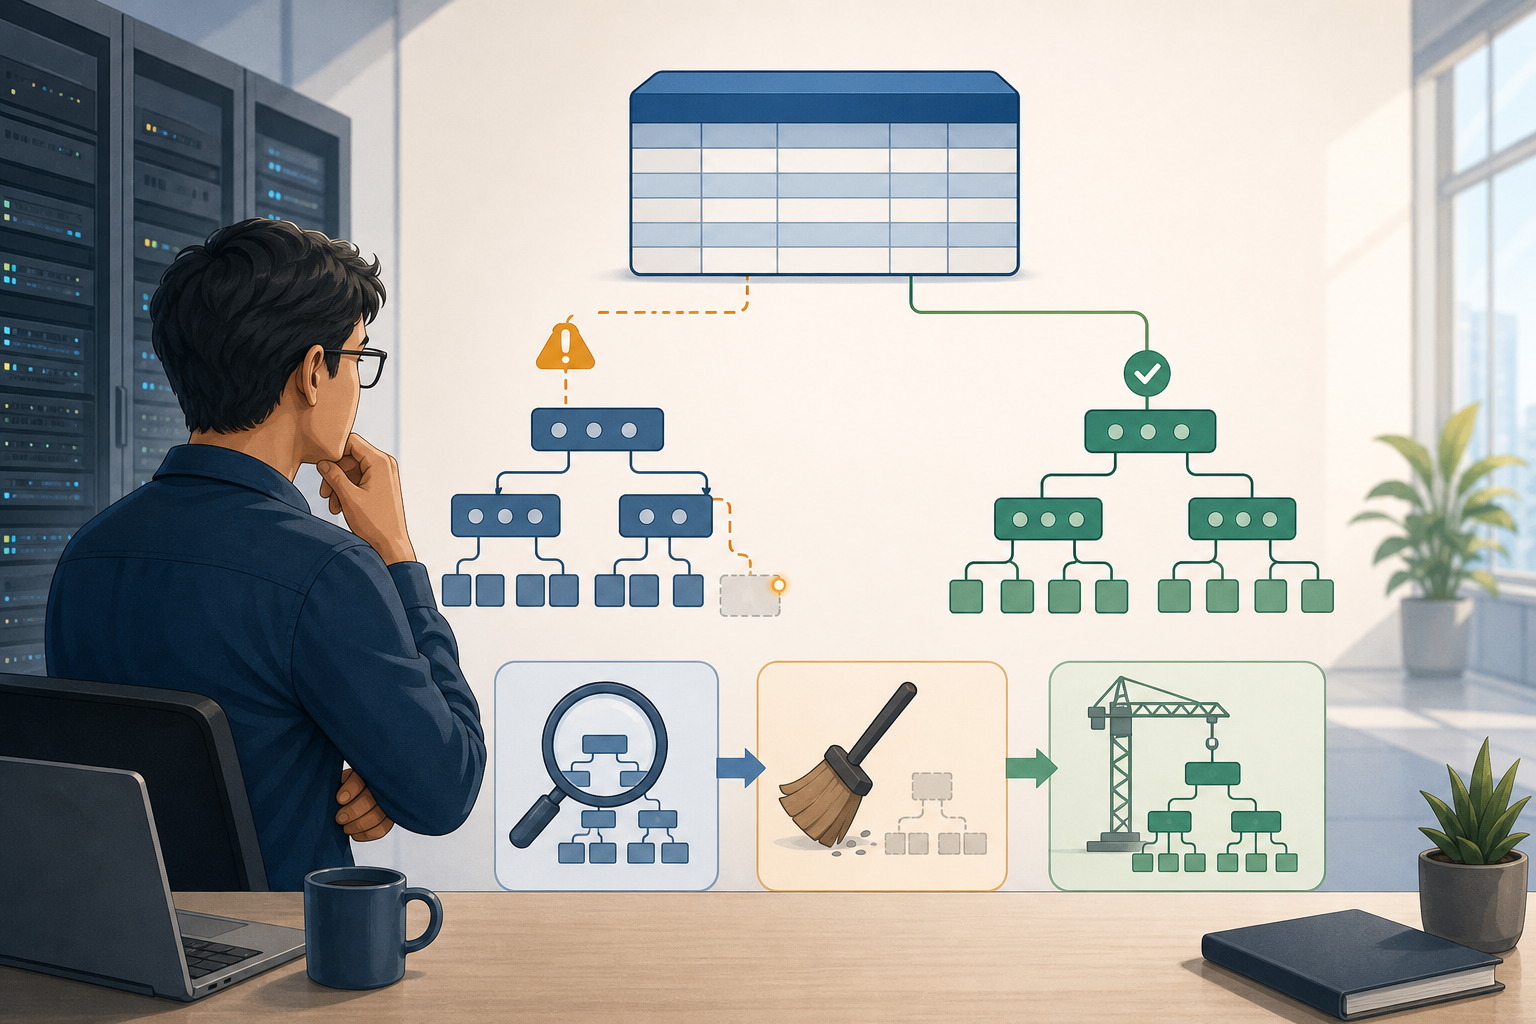
PostgreSQL 16~18에서 CREATE INDEX CONCURRENTLY가 오류로 끝났다면 같은 이름으로 곧바로 다시 만들지 마세요. 먼저 pg_index.indisvalid와 진행 중인 작업을 확인하고, 실패가 확정된 invalid 인덱스라면 원인을 제거한 뒤 DROP INDEX CONCURRENTLY로 정리하고 다시 생성하는 순서가 안전합니다.
invalid 인덱스는 조회 계획에는 쓰이지 않지만 INSERT·UPDATE의 인덱스 유지 비용을 만들 수 있습니다. 특히 UNIQUE 인덱스는 실패 단계에 따라 유일성 검사를 계속할 수 있으므로, 단순히 “사용되지 않는 인덱스”라고 보고 방치하면 안 됩니다.
대상은 PostgreSQL 16, 17, 18에서 동시 인덱스 생성이 실패했거나 오래 멈춘 것처럼 보이는 상황입니다. indisvalid=false만 보고 삭제하지 말고 pg_stat_progress_create_index에서 아직 생성 중인지 먼저 가르세요. 작업이 끝났는데 invalid라면 실패 원인을 고친 후 동시 삭제와 재생성을 각각 트랜잭션 블록 밖에서 실행하세요.
invalid 인덱스를 발견했을 때 먼저 구분할 것
CREATE INDEX CONCURRENTLY는 카탈로그에 invalid 상태의 인덱스를 먼저 등록하고 두 차례 테이블 스캔과 검증을 거친 뒤 valid로 바꿉니다. 따라서 indisvalid=false는 실패의 증거일 수도 있고, 아직 정상 작업이 진행 중이라는 표시일 수도 있습니다. PostgreSQL 18 공식 문서도 이 생성 단계를 명시하고 있습니다.
적용 조건·영향 범위
| 항목 | 적용/확인 내용 | 운영 영향 또는 예외 |
|---|---|---|
| 대상 버전 | PostgreSQL 16~18 | 현재 문서는 18 기준이며 16·17의 같은 명령 문서도 함께 확인해야 합니다. |
| 필요 권한 | 카탈로그 조회 권한, 인덱스 소유자 권한 | DROP INDEX는 인덱스 소유자가 실행합니다. |
| 트랜잭션 | CREATE/DROP INDEX CONCURRENTLY는 트랜잭션 블록 밖에서 실행 |
배포 도구가 자동으로 BEGIN/COMMIT을 감싸는지 확인해야 합니다. |
| 파티션 테이블 | 부모 파티션 인덱스의 동시 생성은 직접 지원되지 않음 | 각 파티션에 동시 생성한 뒤 부모 인덱스를 연결하는 별도 절차가 필요합니다. |
왜 실패한 인덱스가 남는가
일반 CREATE INDEX는 한 번의 테이블 스캔으로 만들며 쓰기를 막습니다. 반면 동시 생성은 쓰기를 계속 허용하는 대신 여러 트랜잭션과 두 번의 스캔을 사용합니다. 기존 쓰기 트랜잭션과 오래된 스냅샷이 끝나기를 기다리는 단계도 있습니다. 시간이 더 걸리고 CPU·I/O 부담도 더 크지만 운영 중 쓰기를 장시간 막는 위험을 줄이는 방식입니다.
스캔 중 데드락, UNIQUE 중복, 표현식 평가 오류, lock_timeout, 디스크 부족 같은 런타임 오류가 생기면 명령은 실패해도 이미 만든 카탈로그 항목과 인덱스 파일은 남을 수 있습니다. PostgreSQL은 완전성을 보장할 수 없는 이 인덱스를 조회 계획에서 제외합니다. 그러나 변경되는 행의 인덱스 항목을 유지하는 비용은 발생할 수 있어 원인 확인 뒤 정리가 필요합니다.
UNIQUE 동시 인덱스는 더 조심해야 합니다. 두 번째 스캔이 시작되면 다른 트랜잭션에 대한 유일성 검사가 먼저 적용될 수 있고, 그 뒤 생성이 실패해도 invalid 인덱스가 유일성 검사를 계속할 수 있다고 공식 문서가 설명합니다. 삭제 전에 이 인덱스가 제약조건을 뒷받침하는지, 중복 데이터가 실제로 있는지부터 확인해야 합니다.
최소 재현 예제로 상태를 이해하기
아래 예제는 테스트 데이터베이스에서만 실행하세요. 중복값이 있는 컬럼에 UNIQUE 인덱스를 동시 생성해 실패 상태를 관찰하는 구조입니다.
CREATE TABLE lab_order (
    order_id bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    external_no text NOT NULL,
    created_at timestamptz NOT NULL DEFAULT clock_timestamp()
);

INSERT INTO lab_order (external_no)
VALUES ('A-100'), ('A-100'), ('B-200');권한: 테스트 스키마에서 CREATE 권한이 필요합니다. 적용 버전: PostgreSQL 16~18입니다. 예상 결과: 세 행이 들어가며 external_no='A-100'이 두 건이라 다음 UNIQUE 생성이 실패할 조건이 됩니다.
운영 테이블에 중복 데이터를 만들거나 실패를 재현하지 마세요. 운영에서는 기존 오류 로그와 카탈로그 상태를 읽는 진단만 수행하고, 삭제·재생성은 변경 승인과 작업 창을 확보한 뒤 진행합니다.
CREATE UNIQUE INDEX CONCURRENTLY ux_lab_order_external_no
ON lab_order (external_no);권한: 테이블 소유자 권한이 필요합니다. 적용 버전: PostgreSQL 16~18입니다. 예상 결과: 중복값 때문에 명령이 실패하고 같은 이름의 invalid 인덱스가 남을 수 있습니다. 이 명령은 BEGIN과 COMMIT 사이에서 실행하면 안 됩니다.
실행 전 확인은 네 단계로 나눈다
1. 아직 생성 중인지 먼저 확인
SELECT p.pid,
       p.datname,
       p.relid::regclass AS table_name,
       p.index_relid::regclass AS index_name,
       p.command,
       p.phase,
       p.lockers_total,
       p.lockers_done,
       p.current_locker_pid,
       p.blocks_total,
       p.blocks_done
FROM pg_stat_progress_create_index AS p
WHERE p.index_relid = 'public.ux_lab_order_external_no'::regclass;권한: 일반 사용자는 자신의 세션에 대한 상세 정보만 볼 수 있으므로 운영 진단 계정의 모니터링 권한 정책을 따르세요. 예상 결과: 행이 있으면 작업이 진행 중입니다. waiting for writers before validation나 waiting for old snapshots라면 실패로 단정하지 말고 차단 세션과 오래된 트랜잭션을 확인합니다.
진행 중인 작업이 기다리는 세션을 찾아야 한다면 pg_locks와 pg_stat_activity로 차단 세션을 확인하는 순서를 먼저 적용하세요. 기다린다는 이유만으로 세션을 종료하면 업무 트랜잭션을 잃을 수 있습니다.
2. valid·ready·live 상태와 정의를 함께 읽기
SELECT n.nspname AS schema_name,
       t.relname AS table_name,
       i.relname AS index_name,
       x.indisvalid,
       x.indisready,
       x.indislive,
       x.indisunique,
       pg_get_indexdef(i.oid) AS index_definition,
       pg_size_pretty(pg_relation_size(i.oid)) AS index_size
FROM pg_index AS x
JOIN pg_class AS i ON i.oid = x.indexrelid
JOIN pg_class AS t ON t.oid = x.indrelid
JOIN pg_namespace AS n ON n.oid = i.relnamespace
WHERE n.nspname = 'public'
AND i.relname = 'ux_lab_order_external_no';권한: 시스템 카탈로그와 대상 객체 조회 권한이 필요합니다. 예상 결과: 실패가 확정된 사례에서는 보통 indisvalid=false가 보입니다. indisready는 INSERT·UPDATE에 대한 인덱스 유지 여부, indislive는 삭제 진행 상태 판단에 도움을 줍니다. 정의와 크기를 함께 남겨 재생성 SQL과 디스크 계획을 검토합니다.
indisvalid 하나만 뽑아 자동 삭제 목록을 만들지 마세요. 파티션 부모 인덱스를 ONLY로 만든 경우처럼 의도적으로 invalid인 상태도 있고, 동시 생성 중인 짧은 구간도 있습니다. 진행 뷰, 오류 로그, 객체 정의, 파티션 관계를 한 번에 판단해야 합니다.
3. 실패 원인을 제거했는지 확인
UNIQUE 인덱스였다면 중복을 먼저 찾아야 합니다. 아래 쿼리는 삭제 대상을 정하는 쿼리가 아니라 중복 그룹을 확인하는 진단입니다.
SELECT external_no,
       count(*) AS duplicate_count
FROM lab_order
GROUP BY external_no
HAVING count(*) > 1
ORDER BY duplicate_count DESC, external_no;권한: 대상 테이블 SELECT 권한이 필요합니다. 예상 결과: 예제에서는 A-100 한 그룹과 건수 2가 나옵니다. 운영에서는 업무 키를 어떤 행에 남길지 소유 부서가 결정해야 하며, 이 확인만으로 자동 삭제하면 안 됩니다.
deadlock이나 timeout이었다면 당시 서버 로그의 SQLSTATE와 시간대를 확인하세요. 디스크 부족이었다면 테이블스페이스의 여유 공간뿐 아니라 기존 invalid 인덱스와 새 인덱스가 한동안 함께 존재할 공간도 계산해야 합니다. 표현식·부분 인덱스라면 정의에 사용한 함수가 immutable 조건을 지키는지도 확인합니다.
4. 의존성과 복구 기준을 확인
인덱스가 제약조건에 연결되어 있는지, 애플리케이션 배포가 특정 이름을 기대하는지, 모니터링이 해당 인덱스를 기준으로 하는지 확인하세요. 삭제 후 재생성이 실패하면 그동안 조회 성능을 보장할 대체 인덱스가 있는지도 봅니다. UNIQUE라면 중복 유입을 막을 별도 통제가 없는 시간 구간을 만들어서는 안 됩니다.
실패가 확정되면 동시 삭제 후 재생성한다
DROP INDEX CONCURRENTLY도 즉시 끝난다고 보장되지 않습니다. 충돌 트랜잭션이 끝나기를 기다리며, 인덱스 하나만 삭제할 수 있고 CASCADE와 함께 쓸 수 없습니다. 세션의 lock_timeout과 statement_timeout을 확인하고, 시간 초과가 나면 성공 여부를 다시 조회한 뒤에만 다음 단계로 가세요.
DROP INDEX CONCURRENTLY IF EXISTS public.ux_lab_order_external_no;권한: 인덱스 소유자 권한이 필요합니다. 예상 결과: 테이블의 SELECT·INSERT·UPDATE·DELETE를 일반 삭제보다 덜 막는 방식으로 인덱스를 제거합니다. 트랜잭션 블록 밖에서 한 인덱스만 실행하세요.
인덱스 삭제는 데이터 행을 삭제하지 않지만 ROLLBACK으로 되돌릴 수 있는 배포 단계로 설계하면 안 됩니다. 원래 pg_get_indexdef 결과를 변경 기록에 보관하고, 실패 원인을 제거한 뒤 아래 재생성 명령으로 복구합니다. 삭제 결과가 불명확하면 같은 DROP을 반복하기 전에 카탈로그에서 존재 여부를 확인하세요.
CREATE UNIQUE INDEX CONCURRENTLY ux_lab_order_external_no
ON public.lab_order (external_no);권한: 테이블 소유자 권한이 필요합니다. 예상 결과: 중복을 해결했다면 인덱스가 valid 상태로 완성됩니다. 동시 생성은 일반 생성보다 더 오래 걸리고 추가 CPU·I/O를 쓰므로, 작업 창의 여유와 진행 상태를 함께 감시하세요.
실행 후에는 사용 가능 상태까지 확인한다
삭제·재생성 전후 검증표
| 검증 시점 | 확인 항목 | 통과 기준 |
|---|---|---|
| 삭제 전 | 진행 뷰, 오류 로그, 인덱스 정의, UNIQUE 중복 | 생성 중이 아니며 실패 원인과 재생성 정의가 확보됨 |
| 삭제 후 | 같은 스키마의 동일 이름 객체 | 대상 invalid 인덱스가 사라짐 |
| 재생성 중 | 진행 단계, 차단 PID, 디스크·I/O | 대기 원인이 설명되고 서비스 지표가 중단 기준 안에 있음 |
| 완료 후 | indisvalid, indisready, 쿼리 계획 |
두 플래그가 true이고 대표 쿼리의 계획·응답 시간이 허용 범위 |
SELECT i.relname AS index_name,
       x.indisvalid,
       x.indisready,
       pg_get_indexdef(i.oid) AS index_definition
FROM pg_index AS x
JOIN pg_class AS i ON i.oid = x.indexrelid
JOIN pg_namespace AS n ON n.oid = i.relnamespace
WHERE n.nspname = 'public'
AND i.relname = 'ux_lab_order_external_no';권한: 카탈로그 조회 권한이 필요합니다. 예상 결과: 재생성이 끝난 뒤 한 행이 나오고 indisvalid=true, indisready=true여야 합니다. 정의가 작업 승인서와 같은지도 비교하세요.
카탈로그 통과만으로 성능 검증이 끝나는 것은 아닙니다. 대표 SELECT를 EXPLAIN (ANALYZE, BUFFERS)로 실행할지는 실제 부하와 쿼리 안전성을 보고 결정하세요. 쓰기 SQL이나 오래 걸리는 쿼리에 무심코 ANALYZE를 붙이지 말고, 운영에서 허용된 읽기 쿼리와 바인드값으로 계획을 확인합니다.
DROP 대신 REINDEX CONCURRENTLY를 선택할 때
PostgreSQL 공식 문서는 실패한 동시 생성의 기본 복구법으로 삭제 후 다시 CREATE INDEX CONCURRENTLY를 권하며, REINDEX INDEX CONCURRENTLY도 대안으로 제시합니다. REINDEX는 기존 인덱스 정의를 그대로 다시 만들고 이름 전환을 관리해 주므로 정의를 보존하고 싶을 때 유용합니다.
다만 REINDEX도 추가 디스크 공간, 여러 대기 단계, 작업 시간을 요구합니다. 제약조건에 연결된 인덱스, 파티션 인덱스, 시스템 카탈로그처럼 대상 종류에 따라 CONCURRENTLY 제한이 달라집니다. “invalid면 모두 REINDEX”라는 자동 규칙 대신 대상 객체 종류와 버전별 REINDEX 공식 제한을 확인한 뒤 고르세요.
자주 생기는 실수
- invalid를 보자마자 삭제: 아직 생성 중일 수 있으므로 진행 뷰를 먼저 확인합니다.
- 같은 CREATE만 반복: 이름이 이미 남아 실패하거나, 중복·디스크·timeout 같은 원인이 그대로라 다시 실패합니다.
- IF NOT EXISTS로 덮기: 같은 이름 객체가 있다는 알림만 내며 기존 정의나 유효성을 보장하지 않습니다.
- UNIQUE의 잔여 효과 무시: invalid UNIQUE 인덱스가 유일성 검사를 계속할 수 있어 업무 오류와 연결될 수 있습니다.
- 배포 트랜잭션에 포함: CONCURRENTLY 명령은 트랜잭션 블록 안에서 실행할 수 없습니다.
- 일반 DROP 사용: 일반 삭제는 테이블에 ACCESS EXCLUSIVE 잠금을 잡아 다른 접근을 막을 수 있습니다.
- 재생성 완료를 명령 종료만으로 판단: valid·ready, 정의, 대표 쿼리 계획과 서비스 지표를 함께 확인해야 합니다.
정리 기준
가장 안전한 출발점은 “invalid니까 삭제”가 아니라 “진행 중인가, 실패했는가”를 가르는 것입니다. 진행 행이 없고 오류가 확인됐으며 실패 원인을 제거했다면, 정의와 의존성을 기록하고 동시 삭제와 동시 재생성을 차례로 실행하세요. UNIQUE, 파티션, 제약조건 연결 인덱스는 일반 인덱스와 같은 자동 절차로 묶지 않는 편이 안전합니다.
작업이 끝난 뒤에는 indisvalid와 indisready가 모두 true인지, 대표 쿼리의 접근 경로가 데이터 규모와 조건에 적절한지, 쓰기 지연과 디스크가 정상 범위로 돌아왔는지 확인합니다. 이 마지막 검증이 있어야 invalid 잔재를 지운 일이 서비스 성능 복구로 이어졌다고 판단할 수 있습니다.